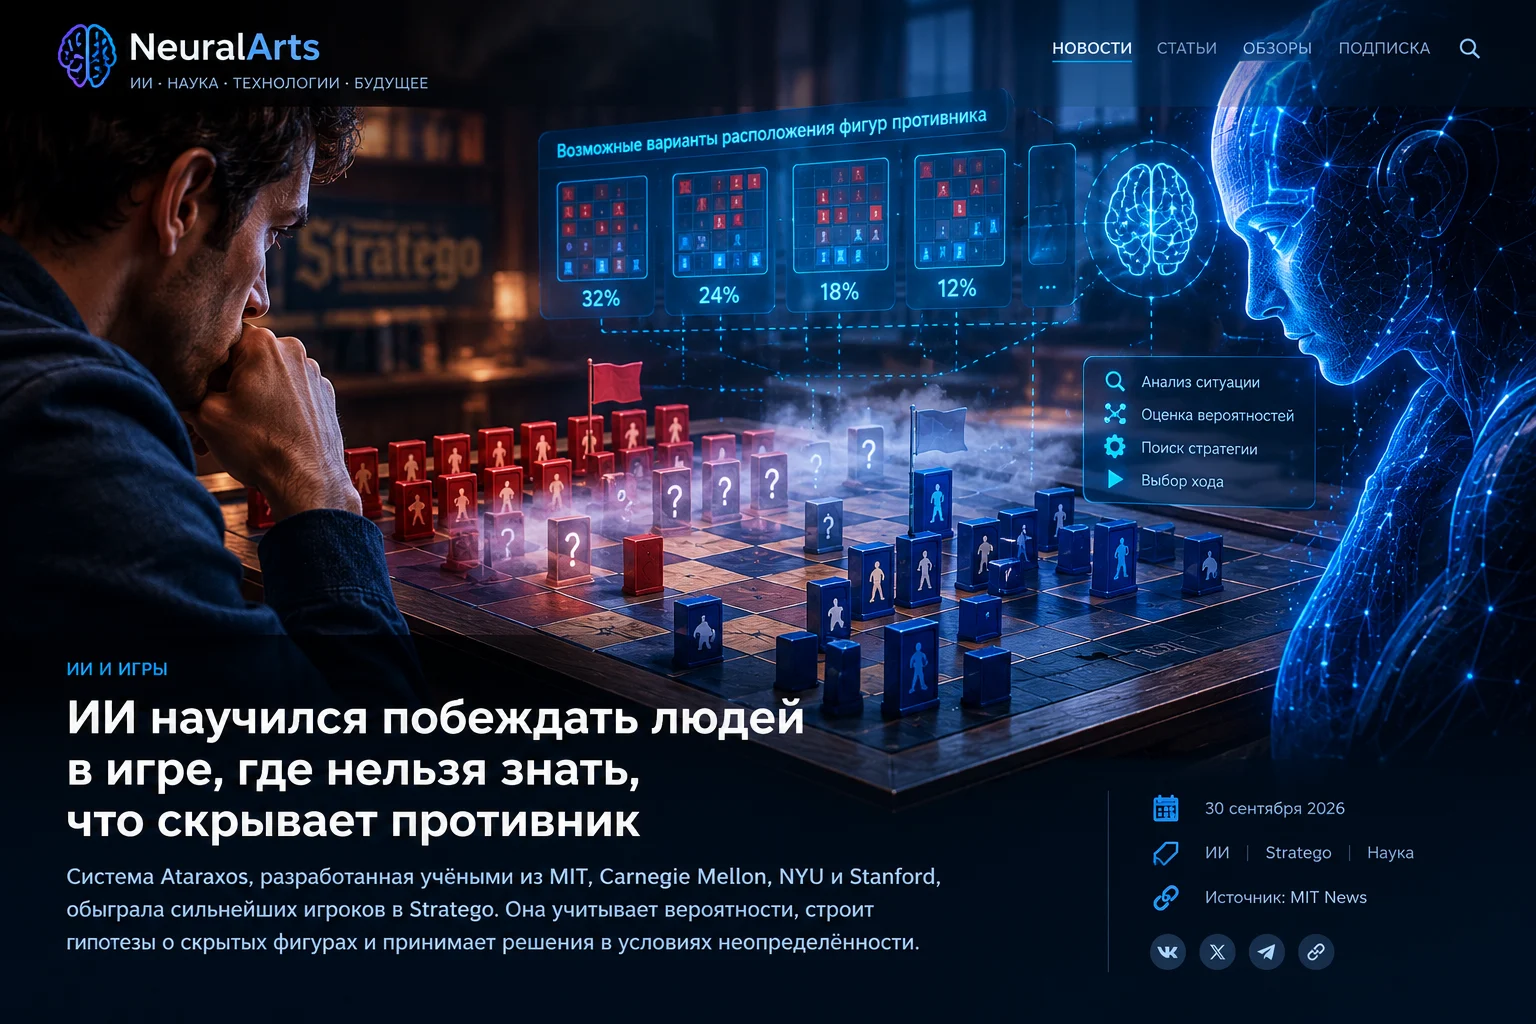
Искусственный интеллект научился играть в Stratego на сверхчеловеческом уровне и уверенно обошёл сильнейших игроков в мире. Система под названием Ataraxos была разработана исследователями из MIT, Carnegie Mellon University, New York University и Stanford University.
Результат интересен не столько очередной победой машины над человеком, сколько самой природой игры. В отличие от шахмат, где оба игрока видят всё игровое поле, Stratego построена на скрытой информации. Игрок не знает, какие именно фигуры находятся у соперника, пока они не столкнутся.
Почему Stratego стала сложной задачей для ИИ
Stratego иногда называют своеобразными «военными шахматами», однако для искусственного интеллекта эта аналогия довольно коварна. Каждый игрок начинает с 40 фигурами, расставленными в секретном порядке. Их характеристики скрыты, а задача заключается в том, чтобы добраться до флага противника.
После столкновения двух фигур их относительная сила определяет исход, однако до этого момента ИИ вынужден работать с предположениями. Он должен решать не только какой ход сделать, но и что, вероятно, находится на неизвестной позиции противника.
Более 1066 возможных конфигураций
Исследователи оценивают количество возможных конфигураций Stratego более чем в 1066. Это огромное пространство вариантов делает игру значительно сложнее многих классических задач, в которых искусственный интеллект уже давно научился превосходить человека.
В шахматах положение всех фигур известно обоим игрокам. В Stratego значительная часть информации скрыта, поэтому оптимальная стратегия зависит ещё и от того, что игрок предполагает о знаниях и намерениях соперника.
Как работает Ataraxos
Создатели системы объединили обучение с подкреплением через самообучение и специальный механизм планирования непосредственно во время партии.
Сначала ИИ учится играть сам с собой
На этапе обучения Ataraxos проводит огромное количество виртуальных партий против собственных версий. Благодаря этому система формирует базовую стратегию, которую исследователи называют «blueprint strategy».
Но на этом обучение не заканчивается. Перед каждым конкретным решением система дополнительно анализирует текущую ситуацию и пытается определить наиболее вероятное состояние скрытой части игрового поля.
ИИ не знает, что находится у соперника
Для этого Ataraxos использует генеративную модель, которая оценивает вероятности того, какие именно фигуры могут находиться на скрытых позициях.
После этого система проверяет возможные варианты развития партии и выбирает действие уже с учётом конкретного противника и текущего положения фигур.
Иными словами, Ataraxos не пытается буквально перебрать все возможные варианты. Он сначала сужает пространство поиска до наиболее правдоподобных сценариев, а затем принимает решение внутри этого пространства.
Результат против людей
Наиболее впечатляющей частью эксперимента стали реальные партии против сильнейших игроков.
Против игрока, занимавшего первое место в рейтинге Stratego, Ataraxos получил результат 15 побед, 4 ничьи и 1 поражение.
На чемпионате мира по Stratego система показала результат 39 побед против 2 поражений в партиях с сильными людьми.
Исследователи также утверждают, что Ataraxos превзошёл предыдущие ИИ-системы, использовав при этом значительно меньше вычислительных ресурсов.
Меньше вычислений, больше результата
По данным команды, Ataraxos достиг более высокой игровой силы, чем система DeepNash от Google DeepMind, используя менее одной сотой обучающих примеров и менее одной тридцатой количества партий самообучения.
Это особенно важно потому, что предыдущие попытки создать сильного ИИ для Stratego требовали значительных вычислительных ресурсов и дорогостоящего обучения.
ИИ учится принимать решения в условиях неопределённости
Главный результат проекта выходит далеко за пределы настольной игры. Stratego интересует исследователей как модель ситуаций, в которых ни одна сторона не располагает полной информацией.
Похожие условия встречаются в переговорах, кибербезопасности, экономике и военном планировании. Участники должны принимать решения, не зная точно, какие действия готовит другая сторона.
От настольной игры к реальным задачам
Исследователи уже проверили Ataraxos не только в классическом Stratego. Систему адаптировали для других игр с неполной информацией, включая Barrage Stratego, Hanabi и Dou dizhu. В этих задачах она также продемонстрировала сверхчеловеческие результаты.
Это позволяет предположить, что разработанные методы могут быть применимы не только к одной конкретной игре, а к более широкому классу задач, где требуется принимать решения при наличии неизвестных факторов.
Что это означает для развития ИИ
Победы в шахматах, го и других играх уже давно стали привычной демонстрацией возможностей искусственного интеллекта. Stratego интересна по другой причине: машине приходится действовать, не имея полной картины происходящего.
Система должна одновременно учитывать собственные действия, возможные намерения противника и вероятность того, что её предположения ошибочны.
Следующий шаг — объяснить решения
При этом исследователи подчёркивают, что для практического применения подобных систем одной высокой точности недостаточно. В дальнейшем команда хочет добавить в Ataraxos инструменты интерпретируемости, которые позволят человеку понимать, почему система выбрала конкретное решение.
Это особенно важно, если подобные алгоритмы когда-нибудь будут использоваться за пределами игр. Победить человека в Stratego достаточно легко объяснить. Намного сложнее будет объяснить человеку, почему алгоритм считает определённую стратегию оптимальной в ситуации, где цена ошибки измеряется уже не проигранной партией.
Обсуждение (0)